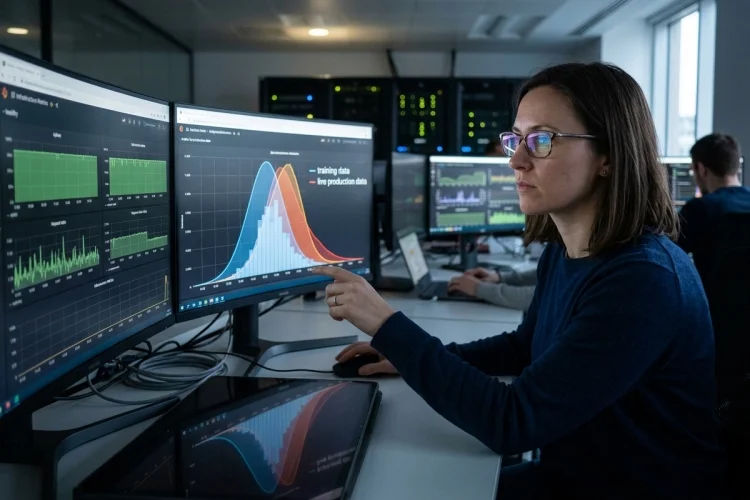
Pertanyaan sulit dalam machine learning production bukan hanya “apakah data berubah?”, tetapi “apakah perubahan itu cukup penting untuk mengambil tindakan?”. Jika setiap perubahan kecil memicu retraining, biaya operasional bisa membengkak.
Sebaliknya, menunggu terlalu lama dapat membuat model terus memberikan keputusan berdasarkan pola yang sudah tidak relevan.
Itulah mengapa Cara Mendeteksi Data Drift perlu dikombinasikan dengan monitoring window, alert threshold, model performance, dan konteks bisnis.
Tujuannya bukan membuat alarm sebanyak mungkin, melainkan menemukan perubahan yang benar-benar membutuhkan investigasi, perbaikan pipeline, atau training ulang.
1. Pisahkan Training-Serving Skew dari Drift
Training-serving skew dan data drift terlihat mirip, tetapi penyebabnya berbeda.
Training-serving skew terjadi ketika data yang digunakan saat serving tidak diproses dengan cara yang sama seperti data training.
Misalnya training pipeline mengubah pendapatan bulanan menjadi jutaan rupiah, sedangkan serving pipeline mengirim angka mentah dalam rupiah.
Data terlihat sangat berbeda bukan karena perilaku pelanggan berubah, melainkan karena pipeline tidak konsisten.
Google menjelaskan training-serving skew sebagai perbedaan antara data atau proses pada training dan serving. Drift, di sisi lain, juga dapat muncul ketika data production berubah dari waktu ke waktu.
Keduanya membutuhkan solusi berbeda.
Skew mungkin membutuhkan perbaikan engineering. Drift nyata mungkin membutuhkan pembaruan data, feature logic, atau model.
2. Gunakan Monitoring Window yang Sesuai Bisnis
Data tidak perlu dibandingkan setiap detik.
Pilih window sesuai kecepatan perubahan bisnis.
Sistem fraud dengan jutaan transaksi per hari mungkin membutuhkan monitoring per jam. Model prediksi churn bulanan tidak perlu alarm setiap 30 menit.
Google Vertex AI memungkinkan monitoring dijalankan sekali maupun secara terjadwal untuk continuous monitoring terhadap data production. Monitoring job menghitung perubahan distribusi dan dapat memicu alert berdasarkan threshold yang ditentukan.
Terlalu pendeknya window juga berbahaya.
Jika hanya 50 observasi masuk dalam satu interval, statistical test dapat menghasilkan sinyal yang tidak stabil.
Sebaliknya, window terlalu panjang dapat menyembunyikan perubahan mendadak.
Pilih periode yang memberikan cukup sample sekaligus masih memungkinkan respons bisnis yang cepat.
3. Buat Threshold Berdasarkan Baseline, Bukan Tebakan
Salah satu kesalahan umum adalah mengambil angka threshold dari blog lalu menggunakannya untuk seluruh fitur.
Padahal setiap feature mempunyai natural variability berbeda.
Misalnya transaction_amount memang sangat fluktuatif setiap hari. Sementara country relatif stabil.
Threshold sebaiknya dikalibrasi menggunakan data historis yang dianggap normal.
Evidently menyediakan default threshold untuk beberapa metode drift, tetapi juga memungkinkan threshold dan metode dikustomisasi. Hal ini penting karena metode seperti Wasserstein, PSI, atau Jensen-Shannon mempunyai karakteristik berbeda.
Ambil beberapa bulan data stabil lalu hitung distribusi drift score.
Dari sana, tentukan batas warning dan critical.
Pendekatan ini jauh lebih kuat daripada mengambil angka universal tanpa memahami karakter data sendiri.
4. Gunakan Multi-Level Alert
Jangan membuat setiap drift menjadi critical alert.
Gunakan severity.
Warning dapat muncul ketika satu fitur penting melewati threshold untuk satu window.
High dapat digunakan ketika drift bertahan beberapa periode atau terjadi pada beberapa fitur utama.
Critical dapat digunakan ketika drift muncul bersama penurunan model performance atau business KPI.
AWS SageMaker Model Monitor mendukung user-defined thresholds dan alert ketika data quality atau model quality mengalami penyimpangan.
Walau sistem monitoring yang digunakan berbeda, konsepnya tetap berguna.
Alert sebaiknya menggambarkan urgensi tindakan.
Jika semua notifikasi dianggap kritis, tim akhirnya berhenti memperhatikannya.
5. Monitor Prediction Drift sebagai Sinyal Tambahan
Feature drift bukan satu-satunya sinyal.
Pantau pula distribusi hasil prediksi.
Misalnya model fraud biasanya menandai 1,5% transaksi sebagai risiko tinggi. Dalam dua minggu, persentasenya meningkat menjadi 12%.
Ada sesuatu yang patut diperiksa.
Azure memasukkan prediction drift sebagai salah satu signal model monitoring selain data drift, data quality, feature attribution drift, dan model performance.
Namun prediction drift juga tidak otomatis berarti model salah.
Mungkin memang terjadi perubahan nyata dalam bisnis.
Misalnya kampanye marketing berhasil mendatangkan banyak pelanggan baru sehingga model churn secara wajar menghasilkan probability berbeda.
Monitoring memberi sinyal. Investigasi menentukan maknanya.
6. Gunakan Multivariate Drift untuk Menangkap Perubahan Hubungan Fitur
Univariate monitoring melihat setiap fitur secara terpisah.
Masalahnya, hubungan antarfitur juga bisa berubah.
Misalnya distribusi umur dan pendapatan masing-masing terlihat normal. Namun kombinasi umur-pendapatan pada pelanggan baru berbeda jauh dari data training.
NannyML menggunakan pendekatan multivariate drift untuk melihat perubahan struktur data secara keseluruhan sebelum melakukan analisis fitur yang lebih spesifik.
Dokumentasi monitoring mereka menunjukkan multivariate drift dapat membantu menemukan perubahan yang kemudian ditelusuri ke feature tertentu.
Pendekatan ini berguna untuk model dengan banyak fitur yang saling berinteraksi.
Tetap kombinasikan dengan univariate analysis supaya tim bisa menemukan root cause setelah anomaly diketahui.
7. Segmentasikan Drift berdasarkan Area Bisnis
Global drift score bisa menipu.
Bayangkan 90% pengguna berasal dari kota besar dan hanya 10% dari daerah rural. Perubahan besar di kelompok rural mungkin nyaris tidak terlihat pada distribusi keseluruhan.
Dengan segment monitoring, perusahaan dapat melihat drift berdasarkan region, produk, channel acquisition, subscription tier, atau kelompok pelanggan penting.
NannyML menunjukkan bahwa segmentasi dapat membantu mengidentifikasi kelompok spesifik yang mengalami penurunan performance atau covariate shift meskipun pola keseluruhan terlihat berbeda.
Segmentasi juga berguna untuk prioritas bisnis.
Drift kecil pada pelanggan enterprise mungkin lebih penting daripada drift lebih besar pada segmen dengan nilai ekonomi rendah.
Monitoring harus mencerminkan konsekuensi bisnis, bukan hanya statistik.
8. Jangan Otomatis Retrain ketika Drift Terdeteksi
Drift detected ≠ retrain model.
Investigasi dulu penyebabnya.
Jika perubahan berasal dari bug upstream, retraining justru membuat model belajar dari data yang salah. Jika perubahan bersifat sementara karena promo akhir pekan, model baru mungkin tidak diperlukan.
AWS menjelaskan bahwa ketika monitoring mendeteksi penyimpangan, tindakan yang mungkin dilakukan mencakup retraining, memeriksa upstream system, atau memperbaiki quality issue.
Ini poin penting.
Retraining hanyalah salah satu remediation.
Buat rule bahwa retraining candidate dibuat ketika drift bertahan, model quality menurun, dan data terbaru telah lolos quality validation.
Dengan begitu, continuous training tidak berubah menjadi continuous instability.
9. Hubungkan Drift dengan Ground Truth
Ketika label tersedia, gunakan itu sebagai pembuktian.
Misalnya model memprediksi default kredit hari ini, tetapi default sebenarnya baru diketahui tiga bulan kemudian.
Begitu ground truth masuk, bandingkan performance berdasarkan periode drift sebelumnya.
Jika feature drift tinggi tetapi AUC tetap stabil, threshold mungkin terlalu sensitif.
Jika drift kecil tetapi recall jatuh signifikan, monitoring perlu diperbaiki atau ada concept drift yang tidak ditangkap oleh feature-level check.
NannyML menekankan perbedaan antara covariate shift dan concept drift; concept drift berkaitan dengan perubahan hubungan antara input dan target dan umumnya lebih sulit dideteksi tanpa informasi performa atau ground truth.
Ground truth membantu mengkalibrasi sistem monitorng berdasarkan dampak nyata.
10. Gunakan Drift sebagai Input untuk Decision Pipeline
Tahap paling matang adalah menjadikan drift monitoring sebagai bagian dari workflow MLOps.
Misalnya:
normal → terus monitor
warning → buat investigation ticket
persistent drift → jalankan evaluation
performance drop → train challenger
challenger lolos → canary deployment
candidate gagal → pertahankan champion
Dengan mekanisme ini, alert tidak berhenti sebagai email yang akhirnya dilupakan.
Google Model Monitoring mendukung threshold dan notification ketika drift melewati batas yang ditetapkan, sedangkan AWS mengaitkan monitoring dengan corrective action seperti retraining atau investigasi sistem upstream.
Tim dapat mengembangkan workflow serupa menggunakan platform apa pun.
Yang penting adalah setiap jenis alert mempunyai owner dan next action yang jelas.
Cara Mendeteksi Data Drift di production harus berujung pada keputusan, bukan sekadar dashboard. Gunakan baseline, monitoring window, threshold bertingkat, prediction drift, multivariate analysis, dan segmentasi.
Hubungkan hasilnya dengan ground truth sebelum memicu retrainig. Mulailah dari beberapa fitur paling kritis lalu bangun workflow alert yang menjelaskan kapan tim cukup memonitor, kapan harus investigasi, dan kapan model perlu dilatih ulang.